Lenovo Yoga Slim 7x alla prova: Snapdragon X2 Plus, autonomia e IA locale in un chilo
Il portatile ARM combina peso ridotto, lunga autonomia e una NPU da 80 TOPS, ma l’utilità dell’intelligenza artificiale locale dipende ancora dal software disponibile.
Il portatile ARM combina peso ridotto, lunga autonomia e una NPU da 80 TOPS, ma l’utilità dell’intelligenza artificiale locale dipende ancora dal software disponibile.
Lo Yoga Slim 7x di undicesima generazione (14Q8Y11) è il portatile con cui Lenovo ha introdotto sulla serie Yoga i nuovi processori Snapdragon X2 di Qualcomm. Noi lo abbiamo provato nella configurazione più economica, con Snapdragon X2 Plus, 16 GB di RAM e 512 GB di SSD. Invece di limitarci a misurarne le prestazioni, abbiamo preferito capire cosa si riesca a fare oggi con l'IA eseguita in locale, cioè direttamente sul computer e senza passare dal cloud, anche su una “macchina base” con relativamente poca RAM.
Ce lo siamo chiesti perché sostanzialmente il laptop si è confermato una macchina agile e veloce nell’uso quotidiano, eppure la domanda è più o meno sempre la stessa da quando Qualcomm ha presentato i suoi chip “Arm per Windows” con una NPU specifica per fare calcoli di intelligenza artificiale in locale. Possibile che non ci sia un modo per sfruttarla, invece di aspettare le convergenze e le strategie di Windows? In effetti ci sono diversi modi: una prova che ci ha aiutato anche a riflettere su potenzialità che potrebbero essere sfruttate meglio, se lo si volesse.
Come si presenta il nuovo Yoga Slim
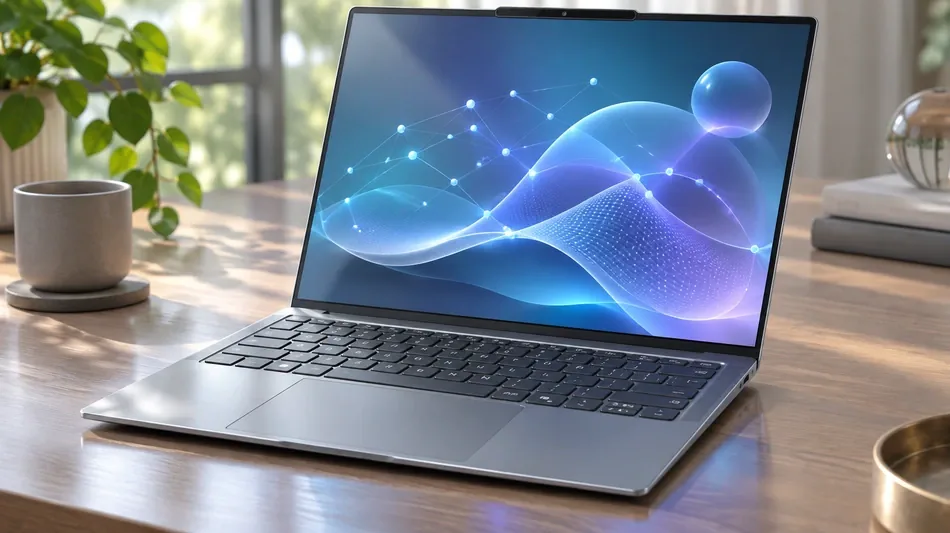
Il telaio è in alluminio anodizzato sabbiato ed è spesso solo 13,9 millimetri. Il Lenovo segna sul display della bilancia 1,17 kg per la nostra versione senza touch. Lo si porta in giro che è un piacere.
Più che premium il design è funzionale; in special modo la tastiera con una corsa dei tasti da 1,5 mm che rende la digitazione a dieci dita un po’ più veloce che su un Mac. La retroilluminazione però lascia intravedere picchi di luce specie sotto la riga dei tasti F/funzione e quella dei numeri.
Il touchpad è in vetro e senza tasti. Nella parte superiore gli switch non possono essere premuti, meglio usare la parte inferiore o i “tocchi senza clic”.
Le porte sono soltanto tre, ma tutte USB-C con USB4 a 40 Gbps, ricarica e uscita video DisplayPort. Non ci sono USB-A, HDMI né lettore di schede, e manca anche il jack audio da 3,5 mm. Non c’è il lettore d’impronte ma la webcam da 9,2 MP (con otturatore e-Privacy per webcam) ha la telecamera a infrarossi per lo sblocco con il volto tramite Windows Hello; ottimo, ma che non funziona in una stanza completamente buia.
Apribile fino a un angolo di 170°, lo schermo è un OLED da 14” in formato 16:10, disponibile in due versioni. Noi abbiamo provato quella da 1920×1200 a 60 Hz e una luminosità dichiarata di 400 nit (600 nits in HDR), ma c’è anche la 2880×1800 che arriva a 120 Hz e 1.100 nit con i contenuti HDR. Entrambe coprono lo spazio colore DCI-P3 e sono calibrate in fabbrica.
L'OLED del Lenovo ha il classico problema del “fringing” derivato da Windows. Sui testi lo schermo non è nitido come ci si aspetterebbe. Il motivo più probabile è la geometria dei subpixel, che negli OLED non segue le tre strisce verticali degli LCD per cui Windows ottimizza i caratteri con ClearType (disattivandolo non si hanno miglioramenti). Sui bordi ad alto contrasto rimane comunque una leggerissima frangiatura colorata, che chi passa molto tempo su documenti e pagine web potrebbe notare.
Lo Snapdragon X2 Plus X2P-42-100 è il chip meno potente della famiglia X2. Ha 6 core, tutti del tipo più veloce (che Qualcomm chiama Prime), contro i 12 e i 18 delle due versioni Snapdragon X2 Elite che Lenovo offre sullo stesso modello. Anche la GPU è la più piccola della gamma. La NPU Hexagon, il processore dedicato ai calcoli IA, è invece identica a quella dei modelli più costosi come l’X2 Elite, con 80 TOPS (80mila miliardi di operazioni al secondo), ed è la parte del chip che conta di più per questa prova.
I 16 GB di memoria LPDDR5X sono naturalmente saldati e non si possono espandere, un limite da tenere presente quando si scelgono i modelli di IA da far girare in locale, che devono stare per intero in RAM.
L'SSD da 512 GB è di tipo QLC, la tecnologia più economica per le memorie flash, e si trova su uno slot M.2 2242 comunque sostituibile (però senza uno sportellino dedicato sul telaio).
La batteria ha una capacità di 70 Wh. Lenovo indica circa 18,5 ore di navigazione web con lo schermo 1920×1200, che però nell’uso quotidiano fatto di uso di più programmi, Photoshop e Word inclusi scendono mediamente a 12 ore arrivando fino allo 0% (profilo Bilanciato) e con due ore di standby a coperchio chiuso. In confezione c'è un alimentatore USB-C da 65 W.
Completano la dotazione il Wi-Fi 7, il Bluetooth 5.4 e quattro altoparlanti con Dolby Atmos. L’ascolto tuttavia è adatto a un “uso office”, perché pur avendo un’ottima spazialità il suono esce dal Lenovo un po’ troppo piatto.
Come detto, la NPU Hexagon dello Snapdragon X2 Plus, il “silicio” dedicato ai calcoli delle reti neurali, è la stessa da 80 TOPS montata sullo X2 Elite. Per capire cosa può fare oggi un portatile come questo lato IA, senza cloud e senza benchmark, abbiamo realizzato quattro piccole applicazioni con l'aiuto di Claude Code.
Fanno cose diverse: cercano le foto per contenuto, rispondono sui documenti, fanno conversazione e generano immagini. Tutte lavorano sul portatile, e con i modelli “caricati” sulla NPU.
La NPU però è bene ricordare che non ha una memoria propria, perché usa i 16 GB di RAM del portatile, condivisi con CPU, GPU e tutti gli altri programmi che girano sulla macchina. Un vincolo che ritorna in ognuna delle app che abbiamo creato e che quindi non possono girare tutte assieme, o almeno non quelle più “potenti”.
Per far girare i modelli abbiamo usato due strade. La prima è GenieX, il motore di Qualcomm per i modelli linguistici. La seconda passa per ONNX Runtime, il motore open source di Microsoft che esegue i modelli salvati in ONNX, un formato comune a molti strumenti IA. Da solo ONNX Runtime usa la CPU, e per arrivare alla NPU gli si aggiunge un modulo di Qualcomm, QNN, che fa da tramite con l’Hexagon, un po’ come un driver. I modelli, già compilati per la NPU, arrivano da AI Hub, il catalogo che Qualcomm mette a disposizione degli sviluppatori.
L'assistente sui documenti: il modello scrive, l'app fa i conti
L'assistente è stata la prima app e quella che ha richiesto più tempo. Volevamo creare una sorta di piccolo “harness”, cioè un contenitore per LLM che può usare anche strumenti terzi, per interrogare velocemente i nostri documenti e cercarli anche per argomento.
Si apre con una scorciatoia o direttamente con il tasto Copilot, e si può usare come semplice chat con una piccola finestra di contesto, oppure collegando una o più cartelle per fare domande sui documenti contenuti in formato testo, Word o PDF.
Il modello linguistico gira sulla NPU tramite GenieX. All’inizio avevamo usato Gemma 4 E4B di Google, nel pacchetto compilato da Qualcomm per lo X2 Elite; ma poi siamo passati a Qwen3 8B di Alibaba quantizzato a 4 bit, eseguito sulla NPU dal motore llama.cpp incluso in GenieX.
Il primo progetto basato su Gemma era un vero agente, un modello che decideva da solo di elencare, leggere e rinominare i file. Ma non ha funzionato perché con 4 miliardi di parametri e una finestra di contesto di 4.096 token (fissata quando il modello viene compilato per la NPU), Gemma inventava parole, dichiarava modifiche mai fatte e contava male le liste lunghe.
Allora abbiamo deciso che tutto ciò che si poteva calcolare lo avrebbe fatto l'app, in modo esatto e istantaneo: contare i file, cercarli, leggerli, e anche controllare l'ortografia con il correttore di Windows. I dati così trovati vengono consegnati al modello che scrive la risposta con una sola chiamata . Per le domande più specifiche l'app sceglie fino a tre passaggi nel documento, e sotto la risposta il pulsante “Fonti” mostra esattamente cosa ha letto. Non lo rende più preciso, ma almeno rende ogni errore verificabile.
Con il modello pronto e caricato in memoria una risposta breve arriva in 2-5 secondi, un riassunto fino a 6.000 caratteri in 5-10. Oltre quella soglia (perché la finestra di contesto è di 4096 token) l'app legge il documento a tappe, da 3.000 caratteri ciascuna, e il riassunto di un testo di 30.000 caratteri richiede uno o due minuti e mezzo. Naturalmente, anche per la RAM a disposizione, è uno strumento adatto perlopiù a piccoli documenti.
La ricerca per significato, che può trovare un documento anche quando non contiene le parole cercate, usa invece EmbeddingGemma 2 su llama.cpp e gira sulla CPU dello Snapdragon, perché GenieX non ha un servizio per questo tipo di modelli.
EmbeddingGemma 2 è un modello di embedding, che non scrive testo ma lo trasforma in una sequenza di numeri, cioè un vettore che ne rappresenta il significato. In pratica, due passaggi che parlano della stessa cosa producono vettori vicini, anche se usano parole diverse .
Quando si collega all'assistente una cartella mai vista, per esempio quella dei nostri articoli di "Gennaio 2025", la prima ricerca la indicizza. L'app legge i documenti, li divide in passaggi di al massimo 1.000 caratteri, accende un piccolo server llama.cpp e calcola un vettore per ciascun passaggio, poi salva tutto su disco insieme alla data di modifica e alla dimensione di ogni file.
Nelle nostre prove l’indicizzazione di 30 articoli ha richiesto 35-40 secondi. A quel punto anche la domanda, "Android", diventa un vettore, e in cima ai risultati finiscono i passaggi più vicini, finanche un articolo sulla nuova versione del sistema operativo di Google che non ne cita mai il nome. Non è comunque infallibile, come si vede in questa immagine dove chiedendo di GPT ci ha tirato fuori un articolo su Netflix
Il lavoro di indicizzazione si fa una volta sola e se la cartella viene scollegata, la ricerca smette di considerarla, ma i suoi vettori restano su disco: ovviamente se la si ricollega non è necessario indicizzarla di nuovo, salvo i documenti che sono cambiati nel frattempo.
Per capire quanta memoria occupasse questa intera soluzione dell’Assistente, e quanto e se lavorasse la NPU, abbiamo dovuto creare una “sotto app” al suo interno: un monitor della memoria.
Infatti, la classica applicazione “Gestione attività” di Windows mostra per il processo di GenieX circa 90 MB, perché conta solo la memoria privata. I pesi del modello stanno invece nella memoria che Windows attribuisce alla NPU e che in Gestione attività non viene mostrata: con il modello caricato la RAM in uso del portatile passa da circa 8 GB a oltre 13 GB, e mentre risponde l'unica cosa che cresce è l'attività della NPU, al 90-100%.
Cercare le foto per contenuto: quando i millisecondi diventano minuti
La seconda app rende un archivio di fotografie consultabile per contenuto, ovviamente svolgendo il lavoro completamente offline, dall’indicizzazione alla ricerca.
Se si scrive "cuscino" o "ragazza con i capelli biondi" compaiono le foto che corrispondono, in ordine di somiglianza. L'idea iniziale era usare YOLOX, un modello di riconoscimento degli oggetti presente su AI Hub, ma YOLOX conosce solo le 80 categorie del dataset COCO; per esempio, il “cuscino” non c'è, così come mancano i “capelli biondi”. Il lavoro di ricerca lo fa quindi SigLIP2 di Google, un modello che trasforma foto e frasi in vettori dello stesso spazio, così che una descrizione e l'immagine che le corrisponde finiscano vicine. È multilingue, e l'italiano funziona quasi come l'inglese. YOLOX è rimasto per ciò che sa fare bene, cioè contare e localizzare persone, auto, cani e gli altri oggetti comuni, con i riquadri disegnati nell'anteprima.
Entrambi i modelli sono stati compilati sul portatile in pochi secondi e girano interamente sulla NPU, con risultati che coincidono con quelli della CPU (la somiglianza tra i due output è 0,999).
Per misurare la precisione abbiamo usato 545 foto reali di Open Images, l'archivio di Google con immagini Flickr in licenza Creative Commons, ma comunque molto piccole: 1024 pixel per lato.
Ma perché passare alla NPU se i modelli per il classificatore delle foto viaggiano bene anche sulla CPU? Del resto, sulla singola foto la differenza di velocità si misura comunque in millisecondi. SigLIP2 analizza un'immagine in circa 4 ms sulla NPU contro 70 ms sulla CPU, che quindi è diciotto volte di più lenta. Anche una frase cercata va trasformata in un vettore, per esempio “ragazza con i capelli biondi” e qui la NPU impiega 2,2 ms contro i 20-32 ms della CPU. Chiaramente, parlando di millisecondi, la differenza non si vede su una singola foto.
La differenza si nota quando l'archivio è grande. Per ogni foto l'indicizzazione, cioè la prima lettura che produce il vettore e l'elenco degli oggetti, richiede sulla NPU circa 30 ms, di cui 9 servono solo ad aprire il file JPEG. Su 10.000 foto sono circa 5 minuti.
Sostituendo ai tempi della NPU quelli misurati sulla CPU per gli stessi due modelli, per tutte le 10.000 foto servirebbero circa 19 minuti, quasi quattro volte tanto.
È qualcosa che fa davvero la differenza per un’attività come l’indicizzazione che si fa una volta sola o quando si aggiungono nuove foto? No, ma abbiamo un “pezzo di silicio” più veloce, che lavora bene e che si trova dentro lo Snapdragon. Usiamolo.
Il generatore di immagini: 1024×1024 in sette secondi
La terza app genera immagini da una descrizione usando l’ormai vetusto modello SDXL Lightning, nella variante DreamShaper XL, una versione di Stable Diffusion XL distillata per lavorare in pochi passi.
Non arriva dal catalogo di Qualcomm, che per le immagini offre solo i vecchissimi Stable Diffusion 1.5 e 2.1, ma da un progetto di un singolo sviluppatore che lo ha compilato per lo Snapdragon X Elite di prima generazione. Sullo X2 Plus gira quindi senza ricompilarlo, e un'immagine 1024×1024 richiede soltanto 7 secondi a modello caricato.
SDXL Lightning rende illeggibili scritte e insegne, ma è un modello dignitoso che può creare immagini semplici e ben strutturate, per esempio per un biglietto di auguri o per un evento scolastico.
Ed è qualcosa che funziona tutto offline grazie alla NPU e su un laptop che si può portare ovunque. Non servono abbonamenti mensili e non ci sono limiti alle immagini da poter generare.
La chat locale e il confronto tra modelli
L’ultima app è una chat semplice con lo stesso motore dell'assistente: si scrive, si allegano documenti, si sceglie il modello da un menu. Con i modelli compilati da Qualcomm il contesto resta fisso a 4.096 token, e il modello vede al massimo 6.000 caratteri di allegati per messaggio, perché nello stesso spazio devono stare anche istruzioni, conversazione e risposta.
Con i modelli GGUF, eseguiti da llama.cpp, come Qwen3-8B quantizzato a 4 bit, il contesto si sceglie all'avvio. Con 8.192 token la quota di allegati sale a 12.000 caratteri, e la memoria di Qwen3 8B sulla NPU passa da 5,7 a 6,3 GB. Ci è servita soprattutto per mettere a confronto i modelli che girano sulla NPU con GenieX, su 16 domande in italiano, 13 delle quali con una risposta verificabile.
Qwen3 8B è risultato il migliore in italiano. Estrae bene i fatti dai documenti, scrive in modo naturale e inventa meno degli altri.
Naturalmente, il “prezzo” di Qwen3 8B è la memoria, circa 6,3 GB in tutto già con 8.192 token di contesto. Con il modello caricato e qualche app aperta restava 1,6 GB di RAM disponibile, e un secondo modello sulla NPU non ci sta. In ogni caso, il Lenovo si è sempre mantenuto abbastanza agile nell'utilizzo office, pur con queste app pesanti in funzione. Naturalmente, in queste condizioni, il consumo della batteria aumenta notevolmente, così come si avverte con più frequenza la ventola che entra in funzione.
Quando il software c'è, la NPU dello X2 Plus su questo Lenovo Yoga Slim è veloce ed efficiente, ma i 16 GB condivisi bastano per un modello impegnativo alla volta. Un risultato atteso, così come erano attesi anche quelli complessivi delle app, realizzate in poco tempo e quindi poco ottimizzate. Eppure, soprattutto l’assistente che permette di avere una chat immediatamente richiamabile e che può anche cercare argomenti all’interno di documenti di una o più cartelle è qualcosa che può rivelarsi utile.
Questo Yoga Slim è una macchina base, che punta soprattutto sulla portabilità e l’autonomia, ma che con modelli opportunamente ottimizzati potrebbe sfruttare anche gli 80 TOPS della sua NPU per far girare diverse soluzioni IA in locale.
Ciò che abbiamo fatto noi in vibe coding in poco più di una settimana potrebbe diventare un’offerta più strutturata e con più risorse da parte di Microsoft, Qualcomm o Lenovo che, abbandonando il retaggio dei PC Copilot+, aiuterebbe anche il mercato di macchine con questi processori.
Naturalmente, sarebbe una scelta che allontanerebbe da un modello economico basato sugli abbonamenti, e servirebbe anche una “decisione politica” delle aziende del settore; ma se abbiamo un hardware potente e flessibile su una macchina, perché non fare di tutto per utilizzarlo?
E.Bansal--MT